
Redakcja datario.pl
Na datario.pl pomagamy wykorzystać w pełni potencjał technologii i danych. Pokazujemy, jak używać dashboardów, AI i nowych technologii, by pracować mądrzej każdego dnia.
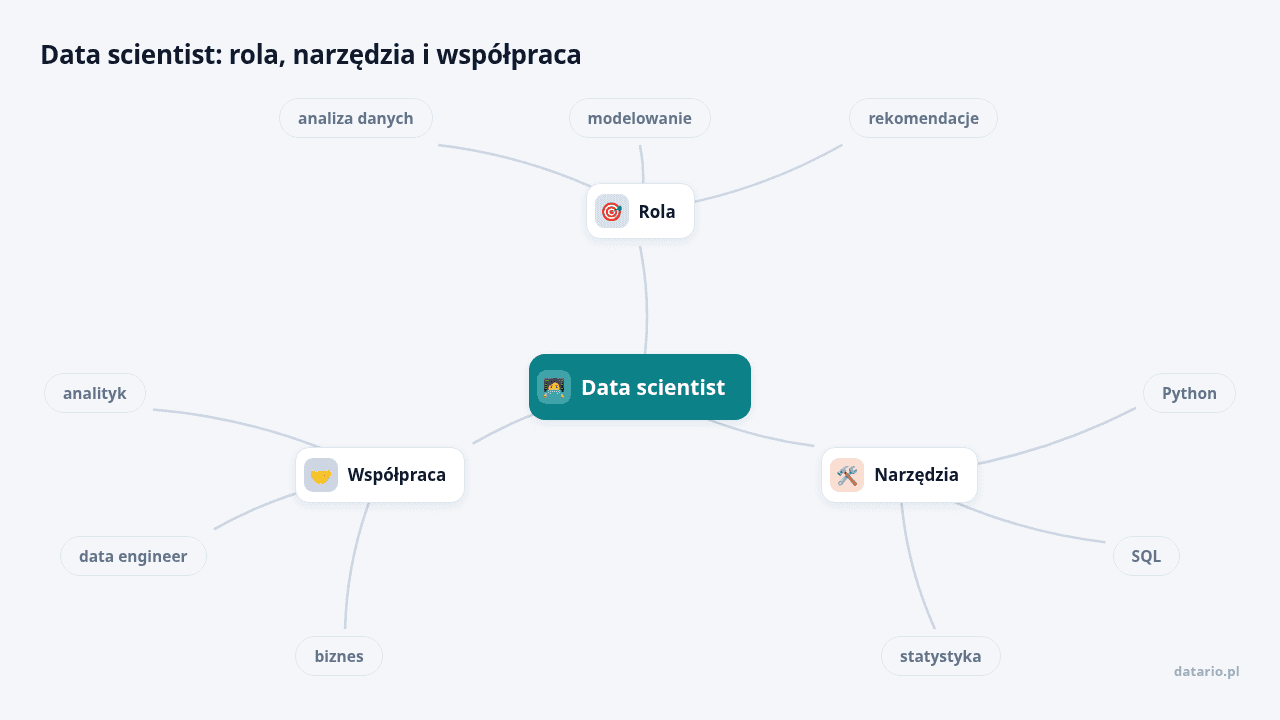
Data scientist, czyli specjalista do spraw nauki o danych, rozwiązuje problemy biznesowe statystyką, programowaniem i uczeniem maszynowym, a w odróżnieniu od analityka danych pyta, co może wydarzyć się później. Najwięcej czasu poświęca jednak na sprawdzanie jakości danych. Według Hays Poland zarabia od 19 000 do 26 000 zł brutto miesięcznie.
Data scientist sięga po dane, statystykę, programowanie i uczenie maszynowe, żeby rozwiązać konkretny problem firmy. Zaczyna od pytania „co się wydarzyło?”, a potem szuka odpowiedzi na kolejne: „dlaczego?”, „co może wydarzyć się później?” i „jaką decyzję warto podjąć?”.
Nauka o danych (data science) łączy kilka obszarów:
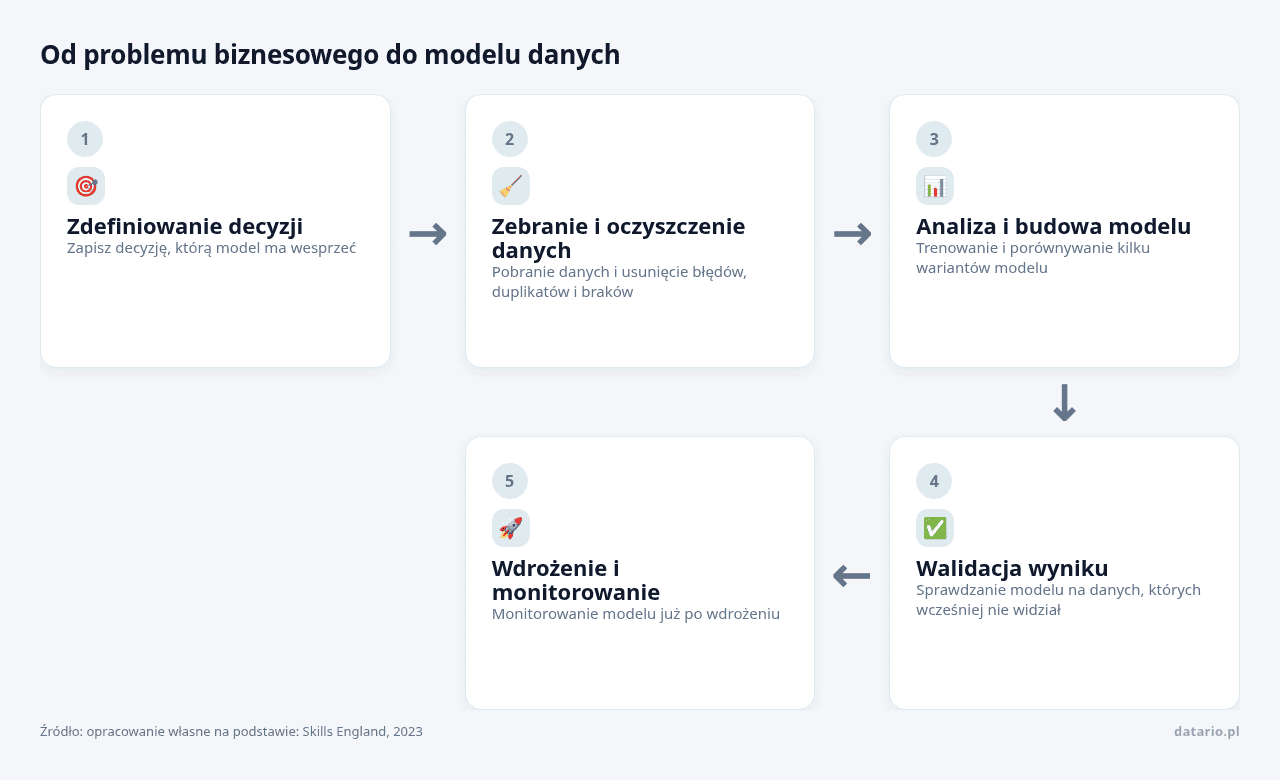
Model matematyczny jest narzędziem, a celem pozostaje lepsza decyzja, automatyzacja powtarzalnej czynności albo mniejsze ryzyko. Standard kompetencji dla tego zawodu wymaga, żeby specjalista umiał przełożyć problem organizacji na problem analityczny, przygotować dane, dobrać metodę, zweryfikować wynik, wdrożyć rozwiązanie i przedstawić rekomendacje osobom nietechnicznym (Skills England, 2023).
W Polsce takie kompetencje dopiero zyskują na znaczeniu. W 2024 r. technologię sztucznej inteligencji wykorzystywało 5,9% przedsiębiorstw, a specjalistów ICT zatrudniało 26,0% firm (GUS, 2025). Spośród firm, które nie korzystały z AI, wdrożenie rozważało jedynie 3,2% (GUS, 2025).
Porada datario.pl: zanim zlecisz budowę modelu albo sam ją zaczniesz, zapisz decyzję, którą model ma wesprzeć. Jeśli nie wiadomo, kto i na podstawie jakiego wyniku podejmie działanie, projekt wymaga doprecyzowania.
Wklej ten prompt do ChatGPT, Gemini, Claude albo innego czatu AI i wpisz swoje informacje w miejsca w nawiasach. Danych wrażliwych lepiej tam nie podawać.
Zanim zatrudnisz specjalistę od danych albo zlecisz pierwszy model, w kwadrans sprawdzisz, którą decyzję w twojej firmie dane naprawdę mogą wesprzeć i czy masz do tego materiał.
Prowadzę firmę z branży [BRANŻA], w zespole mamy [LICZBA OSÓB] osób.
Najwięcej czasu albo pieniędzy kosztuje nas teraz [PROBLEM, NP. NIETRAFIONE ZAMÓWIENIA].
Dane, które już zbieramy, to: [ŹRÓDŁA DANYCH, NP. ARKUSZ SPRZEDAŻY, CRM].
Zaproponuj 3 decyzje, które mogłyby się oprzeć na tych danych. Przy każdej napisz, kto ją podejmuje i na podstawie jakiego wyniku.
Dla każdej decyzji oceń, czy wystarczy raport o tym, co się wydarzyło, czy potrzebna jest prognoza.
Wskaż, których danych mi brakuje i jakie błędy czy braki mogą w nich być.
Zaznacz, gdzie w grę wchodzą dane osobowe i co trzeba ustalić z osobą od ochrony danych.
Na koniec doradź, od której decyzji zacząć mały projekt i czy potrzebuję do niego analityka, specjalisty od nauki o danych, czy inżyniera danych.
Pisz prosto, bez żargonu, a każde pojęcie techniczne wyjaśnij jednym zdaniem.Data scientist zamienia pytanie biznesowe w problem analityczny, przygotowuje dane, buduje i sprawdza modele, a na końcu tłumaczy wyniki osobom spoza działu technicznego. W małej firmie jedna osoba prowadzi cały proces. W dużej specjalista często skupia się na jednym obszarze, na przykład prognozowaniu albo wykrywaniu nadużyć.
Dzień pracy może obejmować:
Najwięcej czasu pochłania zrozumienie problemu i sprawdzanie jakości danych, a budowa modelu to tylko jeden z wielu etapów. Kluczowa jest eksploracyjna analiza danych, czyli wstępne badanie zbioru w poszukiwaniu wzorców, braków i wartości odstających. Specjalista pilnuje też różnicy między korelacją a przyczynowością: dwie zmienne mogą rosnąć razem, choć jedna wcale nie powoduje drugiej.
Praca przebiega iteracyjnie, czyli w powtarzanych cyklach. Najpierw powstaje prosta wersja rozwiązania, zespół sprawdza, czy trafia w rzeczywisty problem, i dopiero wtedy ją rozwija.
Data engineer, czyli inżynier danych, buduje i utrzymuje infrastrukturę, która pobiera, przekształca i przechowuje dane. Należą do niej potoki danych, czyli zautomatyzowane procesy przesyłające dane między systemami (Microsoft, 2023). Data scientist korzysta z tak przygotowanych danych, bada je i tworzy modele.
| Rola | Główne pytanie | Typowe zadania | Rezultat |
|---|---|---|---|
| analityk danych | co się wydarzyło i gdzie jest problem? | raporty, wizualizacje, analiza wskaźników | raport, pulpit z miarami, rekomendacja |
| data scientist | co może się wydarzyć i jak to przewidzieć? | statystyka, modele predykcyjne, eksperymenty | model, prognoza, ocena ryzyka |
| inżynier danych | jak dostarczyć właściwe dane na czas? | potoki danych, integracja źródeł, kontrola jakości | uporządkowane, stabilnie płynące dane |
| inżynier uczenia maszynowego | jak uruchomić i utrzymać model w działającym systemie? | wdrożenie, automatyzacja, monitorowanie | działająca usługa |
IBM opisuje inżyniera danych jako osobę odpowiedzialną za architekturę danych, a data scientista jako specjalistę, który analizuje duże zbiory za pomocą statystyki i uczenia maszynowego (IBM, 2022). W małym zespole granice się zacierają, dlatego opis w ogłoszeniu mówi więcej niż tytuł stanowiska.
Porada datario.pl: przeglądając oferty pracy, zaznacz zadania, które zajmują co najmniej połowę opisu. „Data scientist” w nagłówku może w praktyce oznaczać analizę biznesową albo budowę potoków danych.
Data science wymaga jednoczesnego rozumienia danych, matematyki, programowania i celu biznesowego. Najwięcej problemów sprawiają:
Początkujący często kolekcjonują kolejne biblioteki programistyczne i modele. Pracodawca szuka jednak osoby, która dobierze adekwatną metodę i obroni wynik. Do wielu zadań wystarczą proste modele, łatwiejsze do wyjaśnienia i tańsze w utrzymaniu niż sieci neuronowe.
Jednej obowiązkowej drogi nie ma. Pomaga wykształcenie z informatyki, matematyki, statystyki, ekonomii, fizyki lub inżynierii, choć dyplom nie zastąpi praktyki. Realistyczna ścieżka wygląda tak:
Rekrutacja często sprawdza SQL, statystykę, interpretację wykresu, ocenę modelu i umiejętność rozmowy z osobą biznesową. Projekt z jasno opisanym problemem zwykle lepiej pokazuje samodzielność niż certyfikat. Każdy projekt w portfolio opisz według tego szablonu:
PROJEKT: [nazwa]
1. Problem: jaką decyzję wspiera analiza?
2. Dane: źródło, zakres, charakter
3. Założenia:
4. Przygotowanie danych: co poprawiłem, co usunąłem i dlaczego
5. Metoda: wybrany model i powód wyboru
6. Miara jakości: jak oceniam wynik i dlaczego tak
7. Wynik:
8. Ograniczenia:
9. Dalsze działanie: co rekomenduję
Porada datario.pl: zacznij od małego, zamkniętego projektu. Najpierw określ pytanie, źródło danych, sposób pomiaru wyniku i ograniczenia, a model wybierz na końcu.
RODO ogranicza między innymi profilowanie i decyzje oparte wyłącznie na automatycznym przetwarzaniu. Zgodność z prawem zaplanuj na samym początku, bo sposób zbierania danych decyduje, jaki model w ogóle da się zbudować. Przed startem projektu ustal z osobą odpowiedzialną za ochronę danych:
Unijny akt o sztucznej inteligencji (AI Act) wprowadza obowiązki stopniowo i część z nich już obowiązuje. Dotyczy zakazanych praktyk, biegłości w zakresie AI oraz wymagań dla systemów wysokiego ryzyka (Komisja Europejska, 2024).
Według Hays Poland data scientist w Polsce zarabia od 19 000 do 26 000 zł brutto miesięcznie, a najczęściej oferowana kwota to 22 000 zł (Hays Poland, 2025). Raport opiera się na rekrutacjach z 2024 r. i nie zawęża danych do osób początkujących, więc traktuj te widełki jako punkt odniesienia, który nie gwarantuje konkretnej pensji na start.
Porada datario.pl: oddziel pensję brutto na umowie o pracę od kwoty netto na fakturze w modelu B2B. Porównanie ma sens dopiero po uwzględnieniu podatków, składek, płatnego urlopu, choroby i ryzyka kontraktu.
PARP opisuje Inteligentną Platformę dla Energii Odnawialnej (IPEO), która analizuje dane przestrzenne, tekstowe i satelitarne, żeby ocenić lokalizacje pod odnawialne źródła energii. Platforma uwzględnia informacje środowiskowe, klimatyczne, prawne, własnościowe i dotyczące terenu (PARP, 2026). Proces wygląda tak:
Zespół analityków potrzebował na taką ocenę dni, tygodni lub miesięcy, a platforma wykonuje ją w kilka godzin (PARP, 2026). PARP nie podaje porównania dla konkretnego projektu, więc te liczby pokazują rząd wielkości i nie są dokładnym pomiarem. Model stanowi tu jeden element procesu, który zaczyna się od zbierania danych i kończy kontrolą ekspercką. Podobnie wygląda codzienna praca data scientista.
Data scientist rozwiązuje problemy biznesowe za pomocą danych, statystyki, programowania i uczenia maszynowego, na przykład prognozuje popyt, wykrywa oszustwa albo ocenia ryzyko odejścia klienta. Większość dnia zajmują mu jednak rozmowy z zespołami, pobieranie danych przez SQL, czyszczenie zbioru z błędów i duplikatów oraz sprawdzanie, czy model działa równo dla różnych grup. Na końcu tłumaczy wynik osobom spoza działu technicznego, bo celem jest lepsza decyzja, a model służy tylko do jej podjęcia.
Data engineer, czyli inżynier danych, buduje i utrzymuje infrastruktury, która pobiera, przekształca i przechowuje dane. Odpowiada za potoki danych, czyli automatyczne procesy przesyłające dane między systemami, a także za integrację źródeł i kontrolę jakości (Microsoft, 2023). Data scientist pracuje na danych, które w ten sposób otrzymuje. W małym zespole jedna osoba często łączy obie role, dlatego zakres zadań lepiej sprawdzić w treści ogłoszenia.
Tak, bo musisz jednocześnie rozumieć dane, matematykę, programowanie i cel biznesowy. Najwięcej kłopotu sprawiają niepełne dane, wybór właściwej miary sukcesu, przeuczenie modelu i wyjaśnienie wyniku osobom nietechnicznym. Zaawansowane sieci neuronowe nie są potrzebne na start, bo do wielu zadań wystarczą prostsze modele, łatwiejsze do wyjaśnienia i tańsze w utrzymaniu.
Według raportu płacowego Hays Poland data scientist w Polsce zarabia od 19 000 do 26 000 zł brutto miesięcznie, a najczęściej oferowana kwota to 22 000 zł (Hays Poland, 2025). Dane pochodzą z rekrutacji z 2024 r. i raport nie zawęża ich do osób początkujących, więc traktuj je jako punkt odniesienia. Na stawkę wpływają doświadczenie, branża, lokalizacja, rodzaj umowy i to, czy stanowisko obejmuje wdrażanie modeli.
Wypróbuj bezpłatne narzędzia
Skorzystaj z narzędzi, które ułatwiają codzienna pracę!
Płatności online odpowiadały w 2024 roku za 36% wartości transakcji w strefie euro, a BLIK…
Decyzja zakupowa w e-commerce zapada w koszyku – to tutaj użytkownik albo płaci, albo rezygnuje….
Jeśli prowadzisz import lub eksport, z pewnością spotkałeś się z wymaganiem podania „kodu HS" do…
